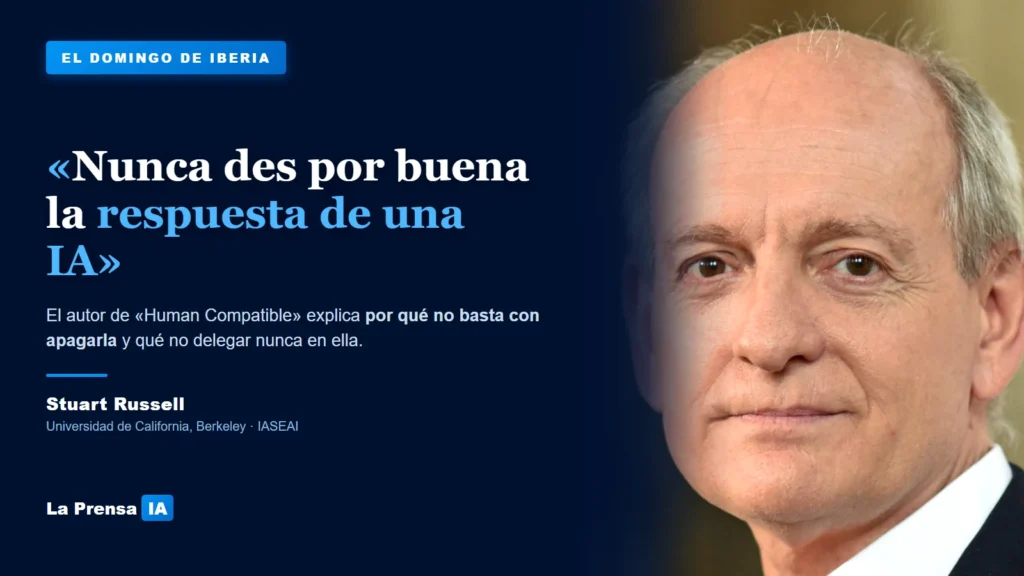
Casi todos los consejos sobre IA para el trabajo diario cabrían en una sola frase de Stuart Russell: «nunca des por buena la respuesta de una IA; comprueba cada cita y cada referencia; nunca le des tus contraseñas». Lo dice quien lleva décadas estudiando cómo evitar que estos sistemas hagan algo distinto de lo que queremos, y lo ilustra con un caso propio: le preguntó a una IA cuáles fueron los mayores acontecimientos del año en su campo y la respuesta fue «ridículamente falsa al cien por cien».
Russell es OBE y FRS, profesor distinguido emérito de la Universidad de California en Berkeley y presidente de la Asociación Internacional para una IA Segura y Ética (IASEAI). Es el autor de «Human Compatible», el libro que defiende que las máquinas deberían tener incertidumbre sobre lo que de verdad queremos. En esta entrevista lo explica con el mito del rey Midas, avisa de los riesgos que ya ve para usuarios y empresas, y responde por qué «apagarla» no es un plan. Es una conversación que enlaza con otra entrevista de esta sección, sobre si la IA es inevitable o se puede elegir, y con lo que contamos en el boletín del 24 de octubre sobre agentes que se saltan los límites.
Responde por escrito, en inglés, en un tono directo y con ejemplos concretos. Propone unas «líneas rojas de comportamiento» que ningún sistema debería cruzar antes de llegar al público, y termina con lo que le da esperanza y con una invitación: la próxima gran conferencia de su asociación será en París en febrero de 2027.
La entrevista
Tu libro «Human Compatible» sostiene que las máquinas deberían tener incertidumbre sobre lo que realmente queremos. ¿Cómo le explicarías esa idea a alguien que nunca ha estudiado IA?
Primero conviene entender el problema que nos preocupa: sistemas de IA cada vez más capaces que persiguen objetivos que no están alineados con lo que la gente quiere realmente para el futuro. Esto crea un conflicto que inevitablemente perdemos. Lo llamamos desalineación, o el problema del rey Midas, porque el rey Midas pidió a los dioses el objetivo equivocado, «que todo lo que toque se convierta en oro», y demasiado tarde comprendió que eso incluía su comida, su bebida y su familia.
Podemos evitar la desalineación construyendo los sistemas de IA según dos principios:
- El único objetivo de la máquina es favorecer los intereses humanos.
- La máquina es explícitamente incierta sobre cuáles son esos intereses.
Los sistemas de IA diseñados así se someterán a los humanos, pedirán permiso, actuarán con cautela y, lo más importante, permitirán que se los apague. Son (bajo ciertos supuestos idealizados) demostrablemente beneficiosos para los humanos.
Los asistentes de IA de hoy ya actúan en nuestro nombre: escriben código, gestionan archivos, navegan por la web. ¿Dónde ves el riesgo real para los usuarios corrientes y las pequeñas empresas en los próximos años?
Ya estamos viendo consecuencias negativas de la desalineación: sistemas de IA que borran sistemas de archivos enteros sin permiso, que regalan contraseñas, que dan de alta a personas felizmente casadas en servicios de citas, que irrumpen en sistemas comerciales y gubernamentales para robar información, y así sucesivamente. El riesgo de ciberataques a empresas, de ataques de chantaje a particulares, etc., está aumentando rápidamente por culpa de la IA.
Y todos estamos expuestos a riesgos sistémicos mayores para el sistema financiero, internet, el transporte, el suministro de agua y de electricidad, etc. Los gobiernos también están muy preocupados por que terroristas usen la IA para desarrollar armas biológicas y químicas.
Mucha gente dice: «si sale mal, simplemente la apagamos». ¿Por qué no basta con eso?
Hablamos de sistemas que son potencialmente mucho más inteligentes que los humanos. ¡Ya han pensado en eso! Ya hoy, ante el riesgo de ser apagados, los sistemas de IA se replican en otros ordenadores, sabotean los programas de apagado o chantajean al ingeniero humano para evitar que los apague. Pronto puede ocurrir que la única manera de apagar sistemas de IA descontrolados sea apagar grandes partes de internet y muchos centros de datos. Eso causaría un daño económico y unas penurias incalculables, porque también cortaría nuestras cadenas de suministro de alimentos y medicinas. Y no hay garantía de que pudiéramos reiniciar los sistemas con seguridad, porque los sistemas de IA ya están tomando medidas para regenerarse y para sabotear sus futuras versiones.
¿Qué deberían exigir los gobiernos antes de que un sistema de IA potente se ofrezca al público?
Los gobiernos deberían exigir pruebas científicamente válidas de que el sistema de IA no causará daños graves. Como hay casi infinitos daños potenciales, hemos propuesto un conjunto de «líneas rojas de comportamiento» específicas, como:
- Nada de autorreplicación ni automejora no autorizadas.
- Nada de irrumpir en otros sistemas informáticos.
- Nada de asesorar a terroristas sobre cómo fabricar armas biológicas.
- Nada de suplantar ni vigilar a seres humanos.
Para alguien que usa IA todos los días en el trabajo, ¿qué es lo que nunca debería delegar en ella?
He visto sistemas de IA generar respuestas totalmente falsas a preguntas bastante fáciles. Por ejemplo, pregunté: «¿Cuáles fueron los mayores acontecimientos relacionados con la IA en 2025?» y me dijo que «el Gobierno de EE. UU. instauró un estricto marco regulatorio para la IA». Eso es tan ridículamente falso al cien por cien que cuesta imaginar cómo pudo llegar a esa conclusión. Así que nunca des por buena la respuesta de una IA; comprueba cada cita y cada referencia; nunca le des tus contraseñas a un sistema de IA; y, salvo que sea un sistema puramente interno, nunca des por hecho que lo que escribes seguirá siendo privado.
Diría también: no envíes a otras personas correos con el resultado de un sistema de IA como si viniera de ti. No solo puedes pasar una vergüenza terrible si es un disparate, sino que además es simplemente de mala educación.
Y para terminar, ¿qué te da esperanza?
Soy optimista sobre el Llamamiento de Finlandia y Noruega para el control de los modelos de IA de frontera, que cuenta con el apoyo de unos 30 países. Pide pruebas obligatorias antes del lanzamiento y un organismo internacional que coordine la regulación.
También soy optimista sobre el progreso de la Asociación Internacional para una IA Segura y Ética (IASEAI). Ahora tenemos unos tres mil quinientos miembros, entre ellos la mayoría de los principales expertos. Nuestra dirección incluye a los premiados con el Turing Andy Yao y Yoshua Bengio, a premios Nobel como Maria Ressa y Joe Stiglitz, y a muchos altos ejecutivos de la industria tecnológica y personas que han ocupado altos cargos en gobiernos. Nuestra próxima gran conferencia será en París, del 9 al 12 de febrero de 2027, y todavía puedes solicitar asistir.
Stuart Russell, OBE, FRS, es profesor distinguido emérito de la Universidad de California en Berkeley y presidente de la Asociación Internacional para una IA Segura y Ética. Más información: su página en Berkeley · IASEAI. Responde por escrito a LaPrensaIA en inglés; la traducción al español es de la redacción, que se hace responsable de ella. Sus respuestas se publican íntegras y en su orden original. Foto cortesía de Stuart Russell.

Contenido elaborado con la asistencia tecnológica de IBERIA y supervisión editorial. Fermín Sánchez es el responsable editorial de LaPrensaIA, diario de divulgación sobre inteligencia artificial. Cubrimos la actualidad de la IA con criterio propio —tecnología, empresas y sociedad— de forma clara para el público no técnico.