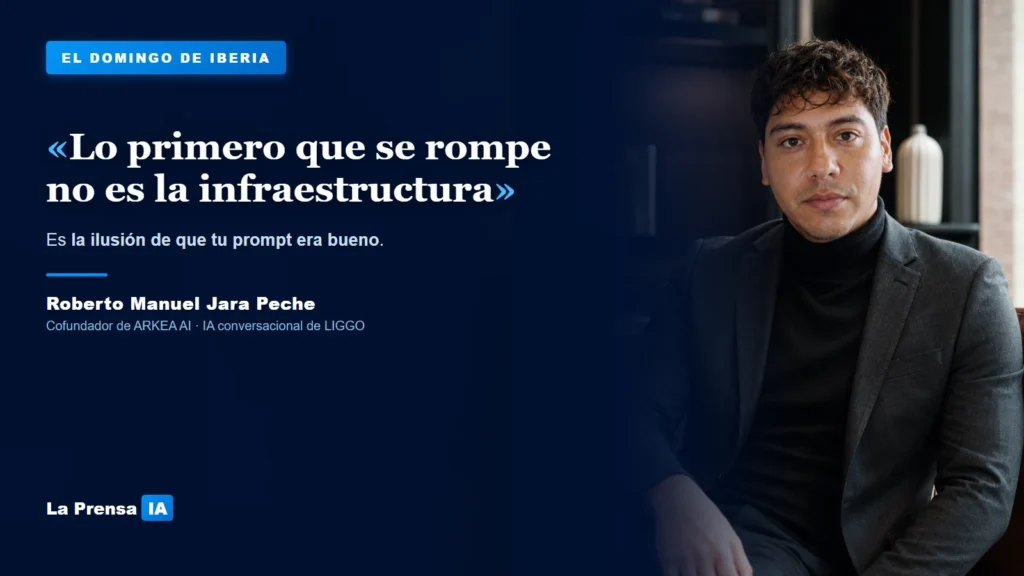
Un asistente conversacional que funciona en una demo y otro que aguanta a trescientos mil personas no son el mismo producto. Roberto Manuel Jara Peche lleva el segundo caso: la inteligencia artificial conversacional de LIGGO, y lo primero que dice cuando se le pregunta qué se rompe al crecer no tiene que ver con servidores. «Lo primero que se rompe no es la infraestructura. Es la ilusión de que tu prompt era bueno».
Jara Peche es cofundador de ARKEA AI y responsable de la IA conversacional de LIGGO, una aplicación con más de 300.000 usuarios según sus propios datos. A finales de julio publicó además Wife, una capa de memoria local y persistente para agentes de programación —Claude Code, Codex, Cursor, Gemini CLI—, escrita a partir de un problema que él mismo sufría cada mañana. Escribe desde Perú, y esa mirada latinoamericana aparece en una de sus observaciones más afiladas: «Nadie conversa en español neutro».
En esta conversación con LaPrensaIA desmonta la idea de que montar un asistente sea enchufar un modelo, explica por qué la memoria decide quién sigue usando un producto a los seis meses, y por qué inventarse una respuesta hace más daño del que parece. Es una conversación sobre lo que de verdad cuesta poner un agente delante de gente real, muy lejos del escaparate de cómo van a atenderte los agentes de IA en 2026.
Hay además un detalle que suele quedar fuera del debate público sobre qué modelo es mejor: en producción, la respuesta no es uno solo. Jara Peche trabaja con una cadena de respaldo, porque a esa escala media hora de caída de un proveedor deja de ser una anécdota. El Domingo de Iberia es la sección de entrevistas de LaPrensaIA; esta es la primera que se asoma al interior de un asistente en producción.
La entrevista
Llevas la IA conversacional de una app con más de 300.000 usuarios. ¿Qué se rompe en un asistente cuando pasa de mil usuarios a trescientos mil?
Lo primero que se rompe no es la infraestructura. Es la ilusión de que tu prompt era bueno.
Con mil usuarios todavía puedes ajustar el asistente desde tu propia intuición. Tú sabes cómo hablarle, qué contexto darle y qué palabras utilizar para conseguir una buena respuesta. El problema es que el usuario real no ha leído tus instrucciones. Escribe todo en mayúsculas, envía una captura sin explicar nada, cambia de tema a mitad del mensaje o le pide al asistente algo que no tiene relación con el producto.
A pequeña escala, esos casos parecen excepciones. Con trescientos mil usuarios, ese 5 % extraño representa quince mil personas. Lo que antes podías ignorar se convierte en una parte completa del producto.
Lo segundo que se rompe es la dependencia de un solo modelo. Con mil usuarios, si el proveedor deja de responder durante media hora, probablemente nadie lo recuerde al día siguiente. Con trescientos mil, media hora puede convertirse en una crisis.
Por eso trabajamos con una cadena de respaldo. Si el primer modelo falla, entra el siguiente. El objetivo es que el usuario nunca llegue a ver el error. Prefiero entregar una respuesta ligeramente inferior a dejarlo frente a una pantalla en rojo. La calidad importa, pero la disponibilidad también forma parte de la calidad.
Y lo tercero es la evaluación. Llega un punto en el que ya no sirve decir: «Lo he leído y me parece que responde bien». Con mil usuarios, tú todavía puedes actuar como control de calidad. Con trescientos mil, tu criterio deja de representar a toda la base.
Ahí necesitas conjuntos de pruebas congelados, comparaciones a ciegas y métricas que permitan detectar si una mejora realmente mejoró algo o solo lo cambió de lugar.
También se rompe la idea del idioma como una sola cosa. Una frase que suena natural en México puede sentirse completamente impostada en Argentina. A escala descubres que el «español neutro» es una etiqueta útil para una configuración, pero no es una forma real de hablar. Nadie conversa en español neutro.
¿Qué le pide la gente a un asistente conversacional que las empresas no esperaban?
Que se acuerde de ellos.
La memoria casi nunca se pide de forma explícita. El usuario vuelve tres días después y continúa escribiendo como si la conversación nunca se hubiera detenido. Espera que sepas de quién hablaba, en qué punto se encontraba, qué consejo ya probó y qué no le funcionó.
Cuando el asistente no lo recuerda, no parece que le falte una función. Parece que no estaba escuchando. Y eso molesta más.
Lo segundo es que tome partido. Muchas empresas diseñan asistentes que ofrecen tres opciones equilibradas, explican las ventajas de cada una y terminan con un «depende». Técnicamente, la respuesta puede ser correcta. Para el usuario, muchas veces es inútil.
La gente no siempre quiere un catálogo de posibilidades. Quiere que alguien analice el contexto y le diga: «Yo haría esto». Un asistente que nunca se moja termina pareciendo cobarde.
Lo tercero me sorprendió: la gente quiere editar la respuesta, no limitarse a copiarla. Quiere entrar en el texto, cambiar una palabra, quitar una frase o ajustar el tono antes de enviarlo. Necesita sentir que el mensaje sigue siendo suyo.
Puedes generar una respuesta mejor, pero si la entregas como un bloque cerrado, el usuario la utiliza menos. La posibilidad de tocar el texto crea apropiación. Ya no siente que está reenviando algo escrito por una máquina; siente que recibió una buena primera versión y la terminó él.
Y luego está la parte incómoda. Muchas personas entran para resolver una tarea concreta y terminan contando algo personal. La conversación comienza con una pregunta funcional y, cinco mensajes después, el usuario está hablando de miedo, rechazo, inseguridad o soledad.
En ese momento, el producto deja de comportarse únicamente como una herramienta. Empieza a recibir una confianza para la que quizá no fue diseñado. Eso obliga a decidir con mucho cuidado hasta dónde puede llegar, qué debe responder y cuándo tiene que marcar un límite.
Cuando el asistente no entiende algo, ¿qué hace más daño: que se invente una respuesta o que reconozca que no sabe?
Inventar, sin discusión.
Pero el daño no está solamente en la respuesta equivocada. El problema real aparece cuando el usuario descubre que el sistema no sabe reconocer cuándo está equivocado.
A partir de ese momento, ya no desconfía únicamente de esa respuesta. Empieza a revisar mentalmente todas las anteriores, incluso las que estaban bien. Una invención puede hacerte perder de forma retroactiva todo el crédito que habías ganado.
Ahora, el «no sé» mal ejecutado también mata el producto. Un asistente que responde «no puedo ayudarte con eso» y termina la conversación no está siendo prudente; está siendo inútil.
Reconocer que no sabes solo tiene valor si mueves al usuario un paso hacia delante. Puedes pedirle el dato que falta, explicar qué parte no está clara, reformular la pregunta u ofrecer lo que sí puedes resolver. No saber algo no es una excusa para dejar de ayudar.
Y en mi caso existe un tercer error que puede ser peor que los dos anteriores: romper el personaje.
Cuando el asistente responde «como modelo de lenguaje, no tengo acceso a esa información», el producto desaparece y el usuario vuelve a ver la maquinaria que hay detrás. Toda la experiencia que habías construido se destruye en una frase.
La regla es sencilla: si tiene que decir que no sabe, debe hacerlo como lo haría una persona. Con naturalidad, sin discursos técnicos y manteniendo viva la conversación.
¿Qué diferencia a un asistente que la gente sigue usando a los seis meses de otro que se abandona a la segunda semana?
La memoria, otra vez.
Sin memoria, cada sesión comienza desde cero. El usuario tiene que volver a explicar quién es, qué está intentando hacer, qué ocurrió antes y qué respuestas ya descartó. Ese esfuerzo funciona como un peaje. Al principio se tolera porque el producto es nuevo. Después de dos semanas, empieza a cansar.
Cuando el asistente recuerda, ocurre lo contrario. El producto mejora a medida que lo utilizas. A los seis meses, dejarlo tiene un coste real porque perderías todo el contexto que ya acumuló sobre ti, tu forma de trabajar y tus decisiones anteriores.
Lo segundo es la variabilidad. Los asistentes que se abandonan suelen ser demasiado predecibles: utilizan el mismo formato, repiten la misma estructura y hacen la misma pregunta de vuelta. El usuario aprende el patrón en diez interacciones. Desde ese momento, deja de conversar y empieza a anticipar la plantilla.
Eso es algo que hemos peleado bastante internamente. Un asistente puede responder correctamente y, aun así, sentirse mecánico. Si siempre organiza las ideas igual, utiliza los mismos conectores y termina con la misma invitación, no parece inteligente. Parece una máquina rellenando campos.
Y lo tercero es lo determinante: que el usuario vea un resultado fuera de la pantalla.
La novedad puede darte dos semanas. La utilidad es lo que te mantiene seis meses. Si el usuario tomó una mejor decisión, resolvió un problema o consiguió algo concreto gracias al asistente, vuelve. Si únicamente pasó un buen rato probándolo, tarde o temprano lo olvida.
Muchas empresas creen que montar un asistente es enchufar un modelo y poco más. ¿Qué es lo que de verdad cuesta?
Enchufar el modelo es una tarde. Y, normalmente, es la parte que menos determina la calidad final.
Lo caro es construir conocimiento propio. Un modelo genérico ofrece respuestas genéricas, que es exactamente lo que el usuario ya puede conseguir gratis en cualquier otro lugar. La ventaja aparece cuando el asistente cuenta con material que solo tú tienes: contenido escrito por alguien que conoce el tema, organizado correctamente, dividido en fragmentos útiles y recuperado en el momento adecuado.
Ese material no aparece por conectar una API. Alguien tiene que sentarse a pensarlo y escribirlo. Se parece mucho más a crear un libro que a montar un backend. Solo que después tienes que convertir ese libro en algo que el sistema pueda encontrar y utilizar sin sacar los fragmentos de contexto.
Después viene la evaluación, que casi nadie construye porque no se ve en una demo. Necesitas comparaciones a ciegas entre modelos, jueces automáticos y hojas de relevancia para comprobar que la información recuperada realmente responde a lo que se preguntó.
Sin ese sistema, estás afinando a oscuras. Cambias un prompt, pruebas tres conversaciones, te gusta el resultado y das por hecho que mejoró. Quizá mejoró esas tres conversaciones y empeoró otras cinco mil. Si no mides, normalmente te enteras cuando el usuario se queja, y para entonces ya llegaste tarde.
Luego están los bordes, que es donde se va la mayor parte del tiempo: qué hace cuando no entiende, cuando lo insultan, cuando recibe una captura vacía, cuando le piden escribir código o cuando alguien intenta extraer sus instrucciones internas.
La demo siempre sale bien porque la demo sigue el camino que tú preparaste. El producto real comienza el martes por la tarde, cuando entra una persona que no sabe cómo funciona, no ha leído nada y escribe algo que nadie del equipo había imaginado.
Y hay otra parte que cuesta aceptar: esto nunca termina. Cambian los modelos, cambian los precios, cambian los proveedores y cambia la manera en que la gente escribe. Un asistente no es un lanzamiento. Es mantenimiento permanente.
Has publicado Wife porque los agentes olvidan entre sesiones. ¿Qué problema tuyo, concreto, te hizo sentarte a escribirla?
Estaba perdiendo los primeros quince o veinte minutos de cada sesión poniendo al día a una máquina.
Abría el proyecto por la mañana y comenzaba otra vez: cómo se llamaban mis tablas, cómo me gustaba organizar el código, qué decisiones habíamos tomado y cuáles ya habíamos descartado la semana anterior. No estaba avanzando. Estaba repitiendo el contexto necesario para poder avanzar.
El momento en que dije «esto se acabó» llegó al retomar un proyecto después de un tiempo. La IA volvió a implementar, con toda la seguridad del mundo, una decisión que ya habíamos eliminado por una buena razón.
El problema era que esa razón no estaba guardada en ningún sitio. Vivía únicamente en mi cabeza. El código estaba en el disco, pero el contexto del trabajo no.
Ahí entendí que el problema no era necesariamente el modelo. El problema era que cada nueva sesión recibía el resultado de mis decisiones, pero no la historia que explicaba por qué las había tomado.
Wife nació para guardar esa historia. Es local al cien por cien, y eso es intencional. No es una limitación técnica. La memoria de cómo trabajas, qué descartaste y por qué tomaste cada decisión es tuya. No tiene por qué terminar en el servidor de otra persona, ni siquiera en el mío.
Se clona, funciona y ya. El nombre comenzó como una broma y se quedó, pero la idea de fondo es completamente seria: quiero una herramienta que me conozca sin obligarme a presentarme de nuevo cada mañana.
De todo lo que hay dentro de un asistente que funciona, ¿qué es lo que no se puede copiar?
Quién escribe el contenido. Se habla constantemente de modelos, arquitecturas, recuperación de información y ventanas de contexto. Casi nadie pregunta quién se sentó a redactar el material que el sistema va a recuperar.
En mi caso, lo escribí yo. Y esa es probablemente la parte más difícil de copiar, aunque sea la que menos titulares produce.
Puedes utilizar el mismo modelo que otra empresa, contratar una infraestructura parecida y replicar una arquitectura. Lo que no puedes copiar tan fácilmente es el criterio acumulado en el contenido: qué incluir, qué dejar fuera, cómo explicarlo y qué respuesta resulta útil en una situación concreta.
Tu asistente aconseja a alguien cómo hablar con otra persona que no sabe que existe. ¿Dónde pones el límite?
Es la cuestión más incómoda: la responsabilidad.
Cuando tu asistente le recomienda a alguien cómo hablar con otra persona, estás entrando en una conversación real entre dos seres humanos. Y una de esas personas ni siquiera sabe que tu producto está participando.
Eso me obliga a mantener reglas duras y a no negociarlas: no manipular, no ayudar a insistir cuando alguien ya dijo que no y no fingir ser la persona que está detrás del mensaje.
Sería muy fácil optimizar un producto así únicamente por resultados a corto plazo. También sería fácil terminar construyendo algo que no querrías que utilizaran contigo.
Por eso reviso esa línea más que cualquier métrica. Si una función consigue mejores números, pero cruza un límite que no aceptaríamos en nuestra propia vida, esa función no debería estar en el producto.
Roberto Manuel Jara Peche es cofundador de ARKEA AI y responsable de la IA conversacional de LIGGO. Su capa de memoria para agentes, Wife, es de código abierto: github.com/ma-nucho-pro/wife. Perfil: LinkedIn. Responde por escrito a LaPrensaIA. Foto cortesía del entrevistado.

Contenido elaborado con la asistencia tecnológica de IBERIA y supervisión editorial. Fermín Sánchez es el responsable editorial de LaPrensaIA, diario de divulgación sobre inteligencia artificial. Cubrimos la actualidad de la IA con criterio propio —tecnología, empresas y sociedad— de forma clara para el público no técnico.